- Des chercheurs de l’Université des sciences appliquées de Fulda et du centre de recherche GSI Helmholtzzentrum für Schwerionenforschung, à Darmstadt, en Allemagne, ont développé une méthode de détection des particules reposant sur un réseau de neurones convolutif (CNN) implémenté sur un FPGA.
- Associé au numériseur de la gamme ADQ35 de Teledyne SP Devices, ce traitement identifie les temps d’arrivée des particules lorsque les impulsions du détecteur se chevauchent, avec une latence annoncée de 300 ns et un débit de traitement de 120 Gbit/s.
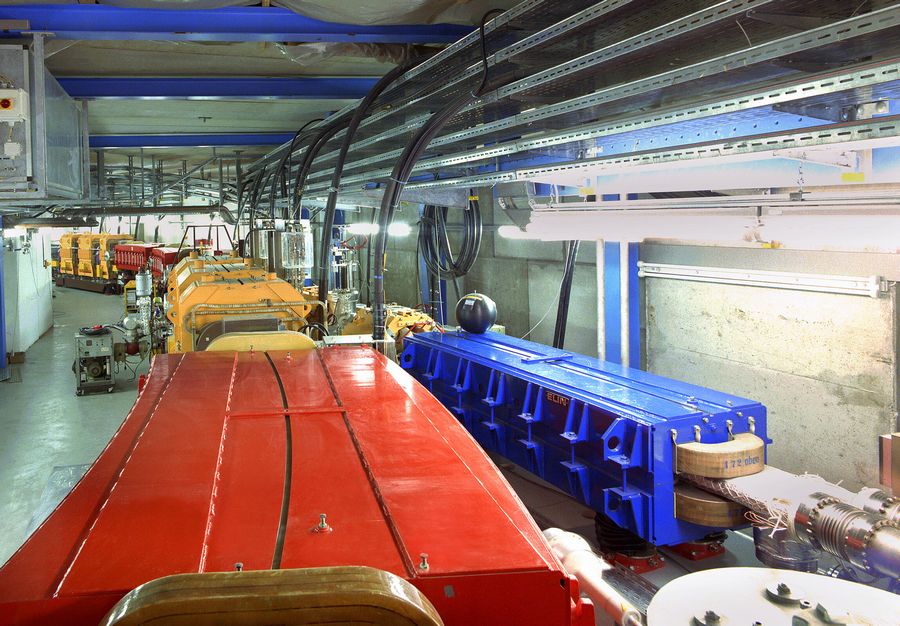
Au synchrotron SIS18 du GSI, le contrôle du faisceau extrait de l’accélérateur, appelé spill, nécessite de connaître le nombre de particules et leur répartition temporelle. Un détecteur placé sur le faisceau génère une impulsion électrique au passage de chaque particule. Lorsque plusieurs particules arrivent à très faible intervalle, les impulsions se superposent. Ce phénomène, appelé pile-up, peut modifier la forme du signal et compliquer l’identification des événements individuels.
Les méthodes conventionnelles, notamment la détection par seuils multiples et la recherche de maxima locaux, peuvent alors manquer certaines particules. Ce sous-comptage affecte la mesure du faisceau et peut limiter l’intensité exploitable lors des expériences.
Pour résoudre ce problème, les chercheurs ont entraîné un réseau de neurones convolutif à partir de données annotées. Le modèle apprend à identifier les impulsions individuelles dans le signal mesuré, y compris lorsque plusieurs événements se chevauchent. Il fournit le nombre de particules détectées ainsi que leurs temps d’arrivée.
Selon les résultats communiqués, cette approche permet de traiter des faisceaux à des taux de particules élevés sans devoir réduire leur intensité pour éviter les phénomènes de pile-up.
Une inférence directement intégrée au numériseur
Le traitement repose sur le numériseur de la gamme ADQ35 de Teledyne SP Devices, qui échantillonne les signaux à une fréquence pouvant atteindre 10 Géch./s et intègre un FPGA AMD Kintex UltraScale KU115. L’implémentation du réseau neuronal sur ce composant permet de traiter les données à proximité de leur acquisition, sans devoir transférer l’ensemble des échantillons vers un système informatique externe pour l’inférence.

Le réseau de neurones convolutif (CNN) traite 32 échantillons en parallèle à une fréquence de 312,5 MHz, soit un débit de 10 milliards d’échantillons par seconde. Avec une résolution de 12 bits par échantillon, le flux de données atteint 120 Gbit/s. La latence annoncée pour l’inférence est de 300 ns, avec un traitement déterministe adapté aux applications de contrôle en temps réel.
La chaîne d’outils utilisée pour entraîner et déployer le réseau a été développée par UFAIRA afin de tenir compte des contraintes de ressources et de calcul propres aux FPGA. Selon les auteurs, le modèle mobilise moins de 15 % des ressources DSP et moins de 6 % des ressources logiques LUT disponibles sur le composant. Cette occupation laisse une marge pour d’autres traitements ou pour l’implémentation de modèles plus complexes.
Une application au traitement de signaux en temps réel
Les travaux montrent l’intérêt de l’inférence sur FPGA lorsque des événements rapprochés produisent des signaux difficiles à séparer avec les méthodes classiques. Le traitement local permet de combiner un débit élevé, une latence réduite et un temps d’exécution déterministe, des caractéristiques importantes pour les systèmes devant réagir pendant l’acquisition.
Au-delà de l’instrumentation des accélérateurs de particules, ce type d’architecture pourrait être appliqué à d’autres traitements de données à haut débit, notamment la surveillance du spectre radiofréquence et la classification de signaux.
Les travaux de recherche doctorale menés à l’Université des sciences appliquées de Fulda avec le GSI constituent la base technologique d’UFAIRA, une entreprise créée en 2026 pour développer des accélérateurs d’inférence sur FPGA destinés aux applications temps réel.